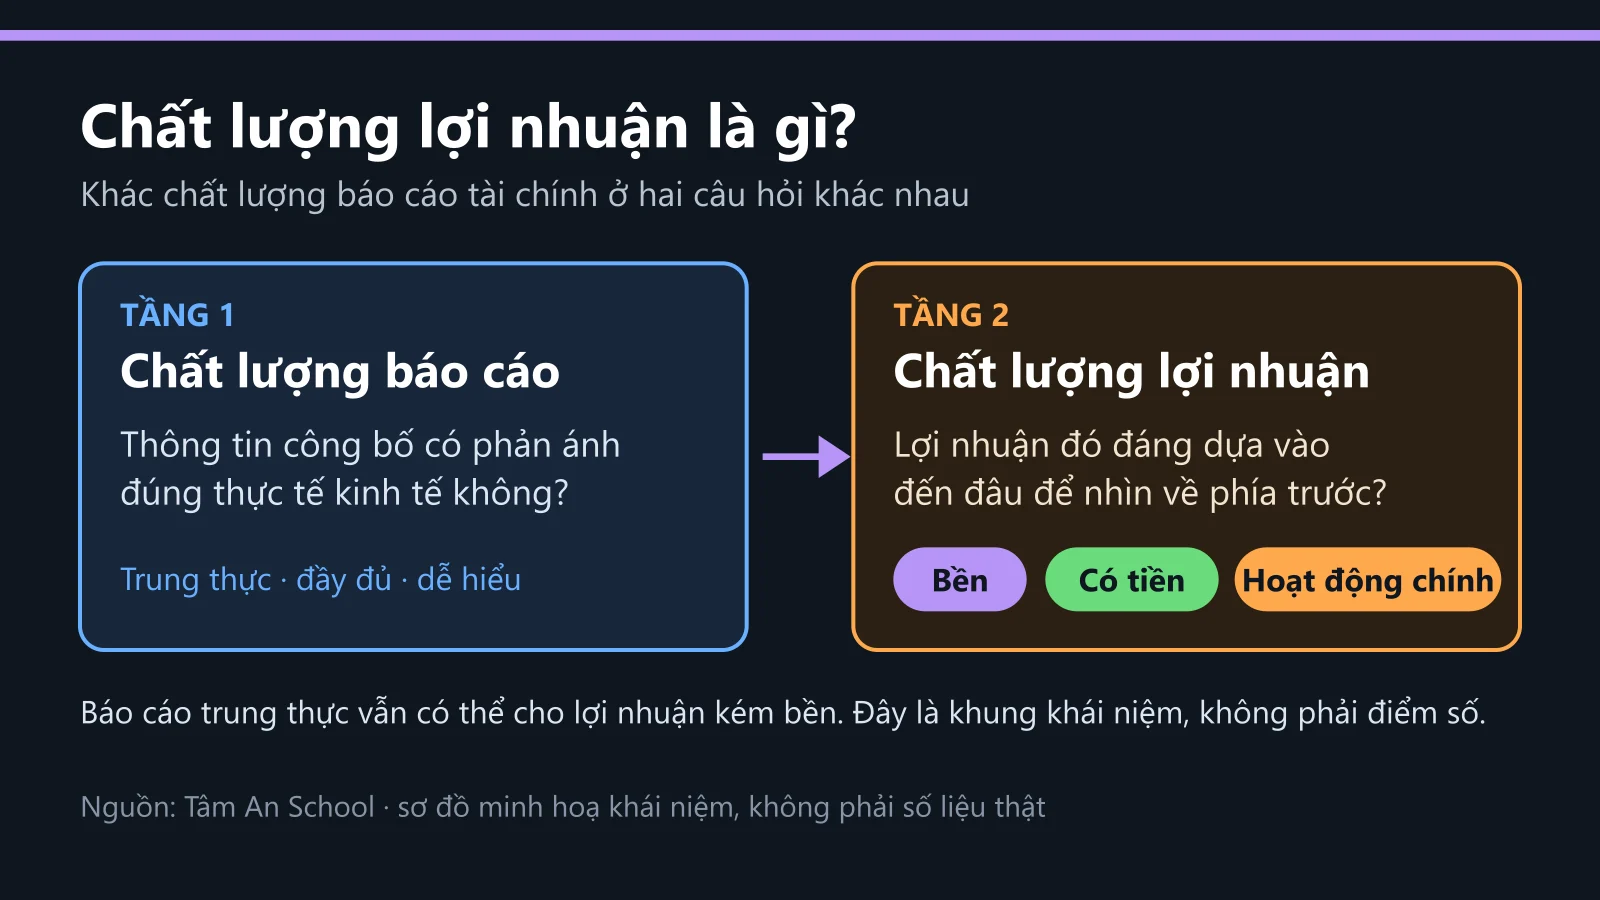
Bài này thuộc hub Đọc báo cáo tài chính — loạt kiến thức đọc báo cáo tài chính nâng cao, không gắn mã cổ phiếu. Tín hiệu trong báo cáo chỉ để sàng lọc, không phải kết luận về một doanh nghiệp cụ thể.
Câu trả lời ngắn
Con số 53,94% trong nghiên cứu của Hoang Hung Dau (2025) không phải tỷ lệ quan sát được phân loại đúng. Theo Bảng 4 của chính bài, đó là trung bình cộng đơn giản của hai tỷ lệ riêng, 85,16% và 22,73%, tính trên hai nhóm cỡ rất khác nhau (128 và 22 quan sát). Tính lại từ Bảng 3, tỷ lệ khớp trên cả 150 quan sát là 76,0%, còn gắn nhãn "không có dấu hiệu" cho mọi quan sát thì khớp 84,0%; trong 24 quan sát lệch lợi nhuận trước và sau kiểm toán từ 5% trở lên, M-Score gắn cờ được 5, tức 20,8%. Chữ "đúng" còn nghĩa là khớp một nhãn đại diện, chưa phải bằng chứng về báo cáo. Số 55,33% của Z-Score bằng 83 chia 150, đúng tỷ lệ quan sát ở vùng an toàn, và Bảng 5 ghi số quan sát phá sản thực tế bằng 0. Bài này diễn giải cách đọc, không bác bỏ nghiên cứu.
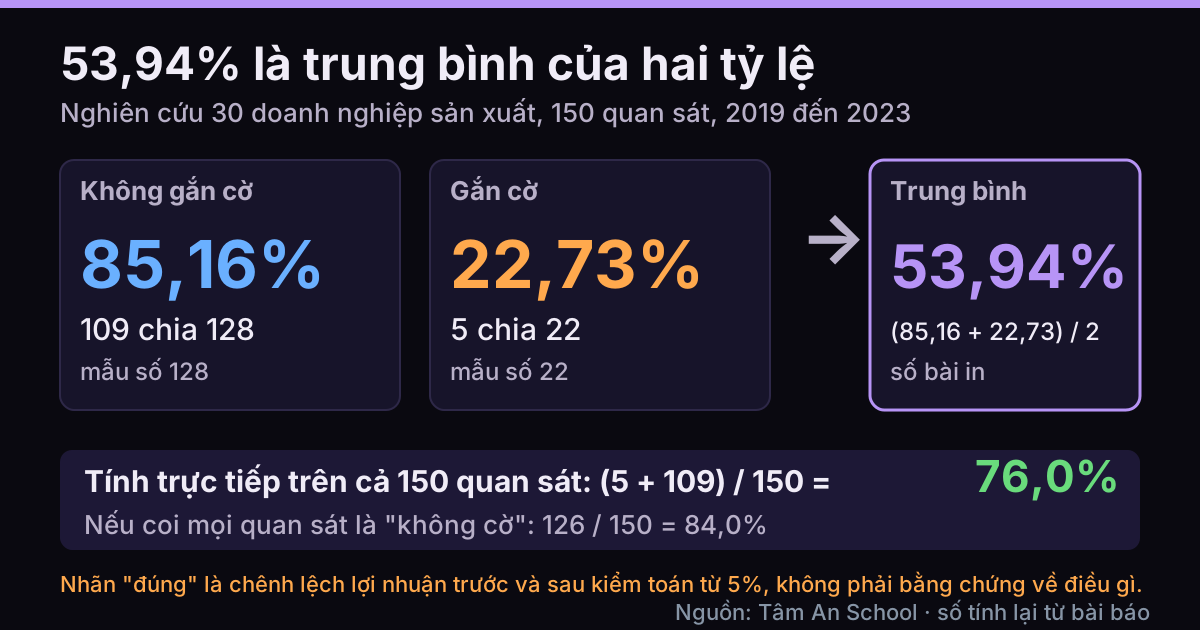
Số tính lại từ Bảng 3 và Bảng 4 của bài báo; Tâm An tự tính bằng Python.
Nghiên cứu này làm gì
Bài đăng trong AISC Proceedings, tập 7, năm 2025, trang 177 đến 186. Mẫu gồm 30 doanh nghiệp sản xuất niêm yết, 2019 đến 2023, tổng 150 quan sát doanh nghiệp-năm (30 nhân 5). Điểm M-Score và Z-Score tính từ báo cáo chưa kiểm toán. Tác giả kiểm ba giả thuyết: M-Score phân biệt được (H1), Z-Score phân biệt được (H2), hai điểm có quan hệ dương (H3); kết luận lần lượt là chấp nhận một phần, chấp nhận, bác bỏ.
Theo cách Tâm An gộp lại, số quan sát ở hai vùng kém tin cậy của M-Score (trên 30 doanh nghiệp mỗi năm) là 2, 1, 2 trong ba năm 2019 đến 2021, rồi 6 năm 2022 và 11 năm 2023; vùng nguy cơ của Z-Score là 7, 1, 1, 4 và 8.
Tác giả gợi ý áp lực sau đại dịch hay biến động vĩ mô nhưng không kiểm định; với 30 doanh nghiệp đó là mô tả của mẫu, chưa phải quy luật thị trường. Bài đăng không nêu mốc điểm của hai mô hình vì chưa đối chiếu được nguồn.
53,94% đến từ đâu
Bảng 3 đối chiếu phân loại của M-Score (gắn cờ hay không) với chênh lệch lợi nhuận ròng trước và sau kiểm toán (từ 5% trở lên hay dưới 5%). Bốn ô là 5, 17, 19 và 109; bài vì sao điểm sàng lọc cao không có nghĩa là gian lận đã dùng chúng cho tỷ lệ cơ sở; bài này xem các tỷ lệ của Bảng 4 được tính thế nào.
Tiêu đề cột của Bảng 3 bị in lệch trong bản đã đọc; Tâm An đọc theo Bảng 4, trong đó 128 và 22 là tổng hai hàng "không gắn cờ" và "gắn cờ". Khi đó:
- 85,16% là 109 chia 128: trong 128 quan sát không gắn cờ, 109 lệch dưới 5%.
- 22,73% là 5 chia 22: trong 22 quan sát gắn cờ, 5 lệch từ 5% trở lên.
- 53,94% là trung bình của hai số trên, (85,16 + 22,73) / 2 = 53,945. Bảng 4 gọi nó là tỷ lệ chính xác trung bình, còn tóm tắt của bài viết là phân loại đúng 53,94% số quan sát; hai cách nói không giống nhau.
Trung bình đơn giản coi nhóm 22 quan sát nặng ngang nhóm 128. Tính trực tiếp trên cả mẫu cho kết quả khác:
| Cách tính | Phép tính | Kết quả |
|---|---|---|
| Trung bình hai tỷ lệ bài in | (85,16 + 22,73) / 2 | 53,94% |
| Khớp nhãn trên cả mẫu | (5 + 109) / 150 | 76,0% |
| Khớp nếu mọi quan sát đều "không cờ" | 126 / 150 | 84,0% |
| Bắt được quan sát lệch từ 5% | 5 / 24 | 20,8% |
Ba điều đọc được. Một, tỷ lệ phân loại đúng tính trực tiếp là 76,0%, không phải 53,94%. Hai, 76,0% thấp hơn 84,0% vì nhóm lệch từ 5% chỉ chiếm 16,0% mẫu (24 trên 150), nên quy tắc "luôn nói không có dấu hiệu" còn khớp nhãn nhiều hơn mô hình; đó là chuyện tỷ lệ cơ sở, không nói mô hình vô dụng. Ba, mô hình bắt được 5 trên 24 ca lệch lớn, khoảng 20,8%, gần với 22,73% (tình cờ), nên nhận xét của tác giả, độ nhạy còn hạn chế, vẫn đứng vững. Nếu tính theo cột, độ nhạy 20,8% và độ đặc hiệu 86,5% (109 chia 126) có trung bình 53,7%, cũng ở vùng giữa: con số của bài không sai hoàn toàn, nhưng gộp hai thứ khác nhau dưới tên "độ chính xác".
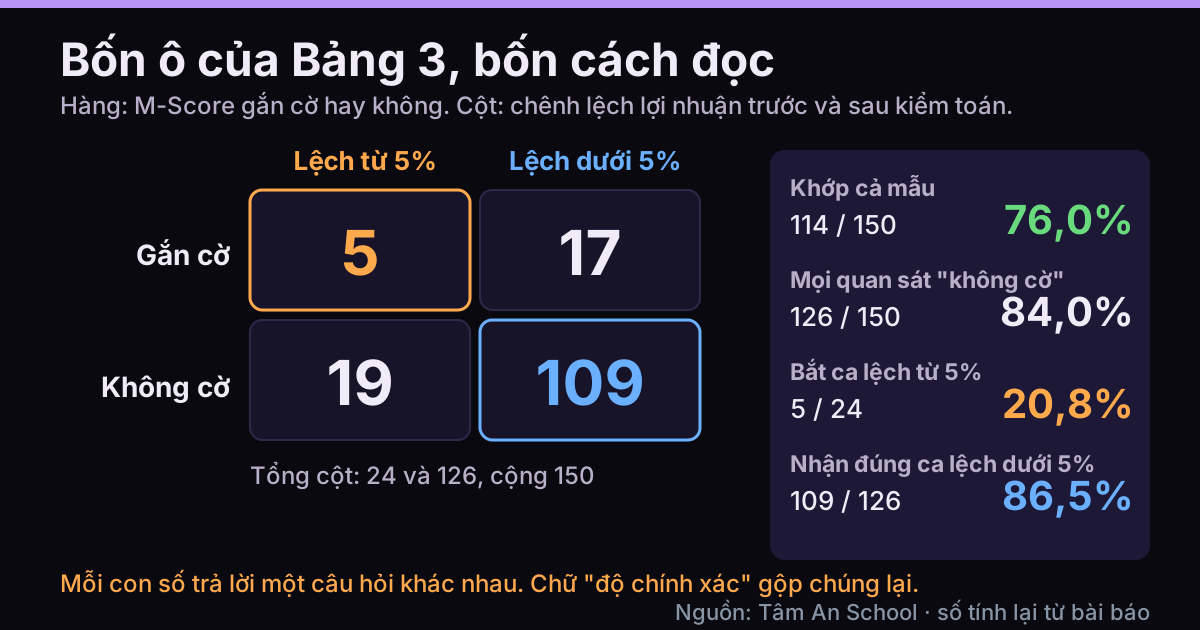
Số tính lại từ Bảng 3 của bài; Tâm An tự tính bằng Python.
"Đúng" nghĩa là khớp với nhãn nào
Nghiên cứu cần một nhãn để so với điểm mô hình. Bài dùng chênh lệch lợi nhuận ròng trước và sau kiểm toán, mốc 5%: dưới 5% coi là báo cáo đáng tin, từ 5% trở lên là không, và viện dẫn Điều 14 Thông tư 96/2020/TT-BTC làm căn cứ cho mốc này.
Tâm An đã đọc Điều 14 khoản 4 điểm c trong bản sao toàn văn thông tư gốc năm 2020. Điều khoản yêu cầu tổ chức niêm yết cổ phiếu và công ty đại chúng quy mô lớn, khi công bố báo cáo, phải đồng thời giải trình nguyên nhân nếu lợi nhuận sau thuế có chênh lệch trước và sau kiểm toán hoặc soát xét từ 5% trở lên, hoặc chuyển từ lỗ sang lãi hay ngược lại. Đó là nghĩa vụ giải trình, không phân loại báo cáo thành đáng tin hay không; "dưới 5% là trung thực" là cách đặt nhãn của nghiên cứu. Nguyên nhân hợp lý khiến hai số khác nhau (ước tính, khoá sổ, sự kiện sau ngày kết thúc kỳ, phân loại, thuế) có bài riêng: vì sao lợi nhuận trước và sau kiểm toán có thể chênh nhau.
Hệ quả cho cách đọc "độ chính xác":
- Chênh lệch từ 5% có thể có nguyên nhân hợp lý: lá cờ "khớp" chưa chứng minh gì về báo cáo, lá cờ "không khớp" chưa chứng minh mô hình sai.
- Chênh lệch ròng dưới 5% có thể che các điều chỉnh ngược chiều triệt tiêu nhau (nhận xét của Tâm An); bài chưa nêu chênh lệch chia cho số trước hay số sau.
- Bùi Phương Chi và cộng sự (2021, VNU) cũng dùng chênh lệch này làm đại diện và tự nêu đó là hạn chế.
55,33% của Z-Score
Bảng 5 so dự báo của Z-Score với tình trạng thực tế "phá sản hay không". Trong bản đã đọc, hai hàng dự báo có tổng 67 và 83, còn cột tình trạng thực tế đều ghi 0. Số 67 bằng 46 quan sát vùng cảnh báo cộng 21 quan sát vùng nguy cơ ở Bảng 2; số 83 bằng số quan sát vùng an toàn. Bảng 6 ghi 83 dự báo đúng trên 150, tức 55,33%.
Cách đọc của Tâm An, là suy luận từ bảng chứ không phải câu của tác giả: không quan sát nào phá sản thật, nên mọi quan sát vùng an toàn đều "đúng" và mọi quan sát ngoài vùng đó đều "sai". 55,33% khi đó là tỷ lệ quan sát vùng an toàn, không là tỷ lệ dự báo phá sản đúng. Nếu coi cả vùng cảnh báo là "an toàn", cùng dữ liệu cho (83 + 46) chia 150 bằng 86,0%: con số đổi vì cách chia vùng, không vì thêm thông tin về phá sản. Tác giả kết luận Z-Score hữu ích để cảnh báo sớm; Tâm An cho rằng mẫu chưa có ca phá sản nào chưa đủ để kiểm tra điều đó.
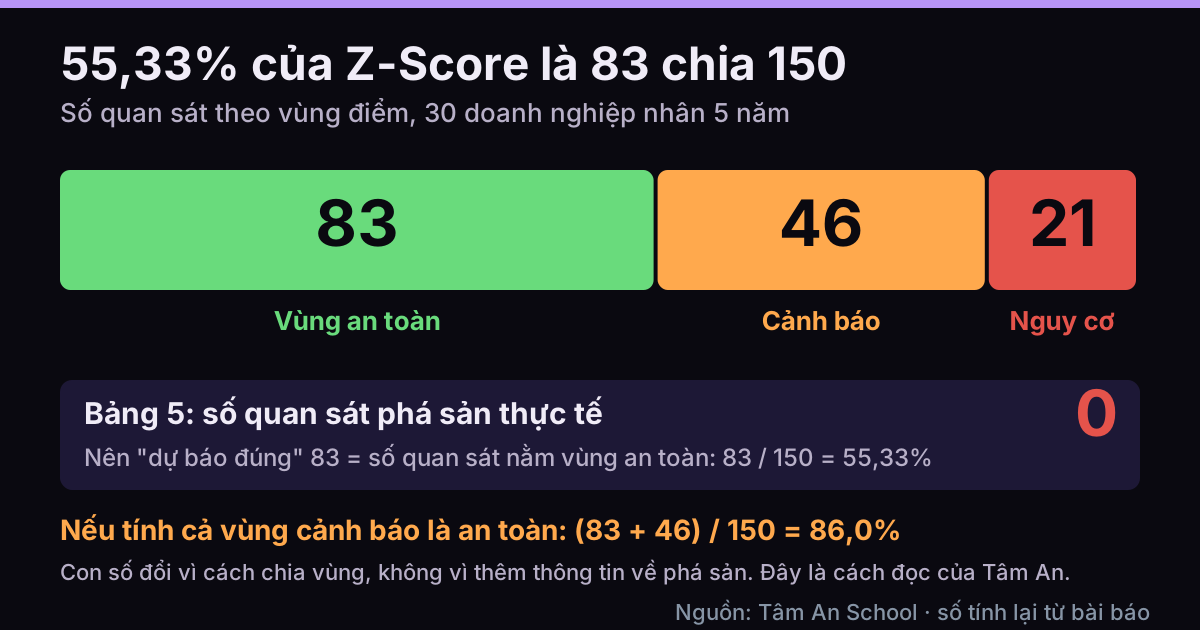
Số tính lại từ Bảng 2, Bảng 5 và Bảng 6 của bài; Tâm An tự tính bằng Python.
Bảng 7 báo hệ số Pearson giữa hai điểm bằng -0,02, mức ý nghĩa 0,806: rất yếu, không có ý nghĩa thống kê, nên tác giả bác bỏ H3 và cho rằng hai mô hình đo hai khía cạnh khác nhau. Không có ý nghĩa thống kê trên 150 quan sát chưa chứng minh hai rủi ro không liên quan.
Ví dụ minh hoạ: nhóm công ty X giả định
Giả sử nhóm công ty X gồm 200 quan sát công ty-năm, số liệu giả định do Tâm An tự đặt, không liên quan nghiên cứu trên. Một mô hình sàng lọc gắn cờ 30 quan sát; nhãn đại diện (chênh lệch lợi nhuận từ 5% trở lên) có ở 40 quan sát. Bốn ô: gắn cờ và có nhãn 10; gắn cờ, không nhãn 20; không cờ, có nhãn 30; không cờ, không nhãn 140 (cộng đúng 200). Tính lại bằng Python:
- Theo hàng: 140 chia 170 bằng 82,35% và 10 chia 30 bằng 33,33%; trung bình đơn giản 57,84%.
- Cả mẫu: (10 + 140) chia 200 bằng 75,0%; mọi quan sát "không cờ" thì 160 chia 200 bằng 80,0%.
- Bắt được quan sát có nhãn: 10 chia 40 bằng 25,0%.
Cùng một mô hình, người đọc thấy "xấp xỉ 58%", "75%" hoặc "25%"; mỗi số trả lời một câu hỏi khác. Với Z-Score, giả sử 100 quan sát của nhóm X có 60 vùng an toàn, 15 vùng cảnh báo, 25 vùng nguy cơ và không quan sát nào phá sản: tỷ lệ "đúng" là 60% hoặc 75% tuỳ cảnh báo tính là rủi ro hay an toàn, và không số nào kiểm tra được khả năng dự báo vì không có ca phá sản.
Cách đọc trên báo cáo
Khi gặp câu "mô hình đạt độ chính xác bao nhiêu phần trăm", hỏi:
- Công thức là gì? Tỷ lệ khớp cả mẫu, trung bình hai tỷ lệ, hay tỷ lệ trên một nhóm? Mẫu số mỗi con số là gì?
- Nhãn "thật" là gì? Chênh lệch trước và sau kiểm toán, dồn tích bất thường, hay phá sản?
- Đường cơ sở là bao nhiêu? Quy tắc "không làm gì" đúng bao nhiêu phần trăm?
- Mẫu có đủ ca thật không? Bao nhiêu quan sát có nhãn dương, chọn thế nào, đã thử ngoài mẫu chưa?
- Dùng vào việc gì? Chọn nơi đọc kỹ, hay kết luận về doanh nghiệp.
Trên báo cáo của một doanh nghiệp thật, nhãn của nghiên cứu này tương ứng với việc đặt lợi nhuận sau thuế của báo cáo quý IV tự lập cạnh số của báo cáo năm đã kiểm toán, rồi đọc giải trình và thuyết minh về các điều chỉnh.
Áp dụng cho từng mã. Khi có báo cáo tài chính thật, trục phân tích theo mã của Tâm An dùng kiến thức này để hiển thị điểm sàng lọc kèm dòng nhắc rằng độ chính xác trong nghiên cứu là con số của mẫu và nhãn riêng; bài không nêu mã cụ thể.
Lưu ý chuyển kỳ: báo cáo năm 2025 lập theo Thông tư 200, từ năm tài chính bắt đầu 01/01/2026 theo Thông tư 99/2025 với mã số chỉ tiêu đánh lại; bài không so mã số chỉ tiêu giữa hai thời kỳ.
Điểm cần cẩn trọng
- Bản đã đọc in lệch tiêu đề cột của Bảng 3 và Bảng 5; cách đọc hàng là phân loại của mô hình, cột là nhãn, dựa trên các tổng của Bảng 4 và Bảng 2, là của Tâm An.
- Bảng 1 của bài có chỗ cộng chưa khớp (hàng 2022 cộng 28 thay vì 30; tổng cột vùng kém nhất ghi 16, cộng các năm ra 17); số theo năm ở trên lấy từ từng hàng. "84% doanh nghiệp" trong tóm tắt thực ra là 126 trên 150 quan sát doanh nghiệp-năm.
- Điều 14 Thông tư 96/2020 đọc từ bản sao thông tư gốc; thông tư đã có văn bản sửa đổi, Tâm An chưa có bản hợp nhất để đối chiếu.
Đừng nói quá
- Không viết "nghiên cứu chứng minh M-Score vô dụng": tác giả kết luận mô hình phân biệt được một phần.
- Không viết "M-Score chính xác 53,94%" hay "Z-Score dự báo phá sản đúng 55,33%": hai số có nghĩa như đã tính ở trên.
- Không viết "doanh nghiệp bị gắn cờ có báo cáo không đáng tin" hay "chênh lệch từ 5% là dấu hiệu sai phạm": nhãn chỉ là đại diện.
- Không dùng bài này để kết luận về một cổ phiếu. Bài không phải khuyến nghị đầu tư.
Tín hiệu không phải kết luận
Một con số "độ chính xác" của nghiên cứu là tín hiệu để hỏi thêm về công thức, nhãn và mẫu, chưa phải kết luận rằng mô hình dự báo tốt hay kém, càng chưa phải kết luận về một doanh nghiệp. Điểm sàng lọc cũng chỉ là lý do để đọc thêm thuyết minh, dòng tiền và báo cáo kiểm toán.
Căn cứ
Căn cứ kiểm ngày 17/10/2026.
- Hoang Hung Dau (2025), "Financial Statement Fraud and Bankruptcy Risk in Listed Manufacturing Firms in Vietnam", AISC Proceedings, tập 7, tr. 177-186: đã đọc toàn văn, Bảng 1 đến 7 (tr. 181-184); số "tính lại" là Tâm An tự tính bằng Python.
- Bùi Phương Chi, Nguyễn Thị Hồng Thúy, Lăng Trịnh Mai Hương (2021), VNU Journal of Science: Economics and Business, 37(1): 40-49: chỉ dùng phần nhãn và hạn chế (tr. 44, 49).
- Thông tư 96/2020/TT-BTC, Điều 14 khoản 4 điểm c: đọc từ bản sao toàn văn thông tư gốc; cần đối chiếu bản hợp nhất.
- Số liệu ví dụ nhóm công ty X: Tâm An tự đặt, tính lại bằng Python ngày 17/10/2026.
Đọc thêm
- Chất lượng lợi nhuận là gì? (trụ cột)
- Mô hình sàng lọc báo cáo tài chính là gì
- Beneish M-Score: tám chỉ số đo điều gì
- Altman Z-Score gốc, Z' và Z'' khác nhau thế nào
- Vì sao điểm sàng lọc cao không có nghĩa là gian lận
- Vì sao lợi nhuận trước và sau kiểm toán có thể chênh nhau
Cả chuỗi: chuyên mục Đọc báo cáo tài chính.
Nghiên cứu của Hoang Hung Dau (2025, AISC, tập 7) trên 30 doanh nghiệp sản xuất niêm yết, 150 quan sát doanh nghiệp-năm, giai đoạn 2019 đến 2023, báo cáo độ chính xác 53,94% cho M-Score và 55,33% cho Z-Score. Tính lại từ các bảng của bài: 53,94% là trung bình đơn giản của 85,16% (109 trên 128) và 22,73% (5 trên 22); tỷ lệ khớp nhãn trên cả mẫu là 76,0%, thấp hơn 84,0% của quy tắc coi mọi quan sát là không có dấu hiệu, và M-Score bắt được 5 trên 24 quan sát lệch lợi nhuận từ 5% trở lên, tức 20,8%. Nhãn là chênh lệch lợi nhuận trước và sau kiểm toán, trong khi Điều 14 khoản 4 điểm c Thông tư 96/2020 là nghĩa vụ giải trình, không phân loại báo cáo. Với Z-Score, 55,33% bằng 83 trên 150, tỷ lệ quan sát vùng an toàn, và Bảng 5 ghi 0 quan sát phá sản thực tế; coi cả vùng cảnh báo là an toàn thì cùng dữ liệu cho 86,0%. Nhóm công ty X giả định (200 quan sát) cho 57,84%, 75,0% và 25,0% từ cùng một mô hình. Con số độ chính xác chỉ là tín hiệu để hỏi về công thức, nhãn và mẫu, chưa phải kết luận về mô hình hay doanh nghiệp, và không phải khuyến nghị đầu tư.
Nội dung mang tính giáo dục, không phải tư vấn đầu tư. Tín hiệu và mô hình chỉ để sàng lọc, không phải kết luận. Căn cứ pháp lý có thể thay đổi; luôn đối chiếu văn bản hiện hành.